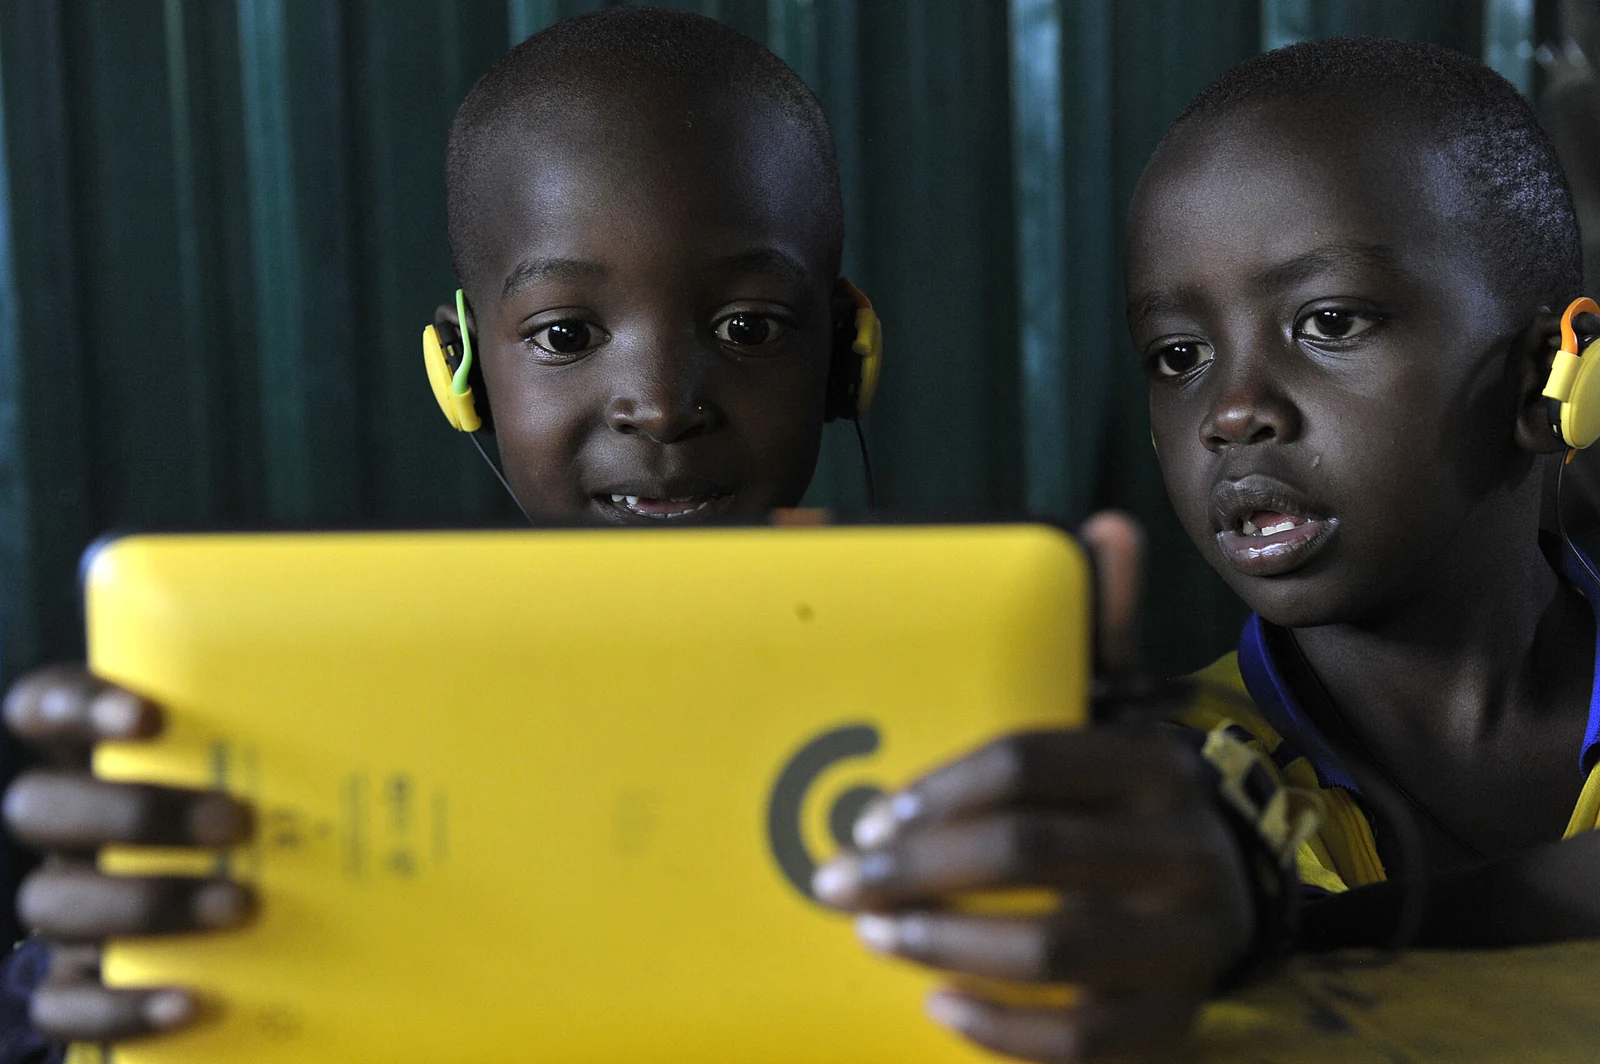
Demandez à un chatbot d'IA de premier plan une question en isiXhosa, Hausa ou Luganda couramment et les résultats chutent rapidement. Les systèmes qui semblent presque magiques en anglais se situent, pour la plupart des langues africaines, entre maladroits et inutiles. Une communauté croissante de chercheurs et de start-ups africains essaie de changer cela, et l'effort constitue l'un des projets techniques les plus conséquents du continent. Cet article explique qui construit, pourquoi c'est difficile et ce qui est en jeu.
L'ampleur du fossé
L'Afrique compte plus de 2 000 langues vivantes. Les grands modèles de langage grand public ne maîtrisent qu'une fraction minime d'entre elles. Une enquête de 2025 sur le domaine a révélé qu'un très petit nombre de langues africaines, dont l'amharique, le swahili et l'afrikaans, sont de façon fiable prises en charge, tandis que la plupart des langues africaines demeurent pratiquement non prises en charge. La raison pour laquelle ces systèmes fonctionnent si bien en anglais et si mal ailleurs est simple : ils apprennent à partir de données, et Internet est écrasante en anglais.
Qui construit
La réponse a été un écosystème auto‑développé plutôt qu'un projet héroïque unique. L'initiative Masakhane, un collectif de recherche panafricain, consacre des années à la création de jeux de données open‑source, de benchmarks et d'outils de traduction couvrant des dizaines de langues. Le laboratoire sud-africain Lelapa AI a lancé InkubaLM, un modèle multilingue compact couvrant le swahili, le yoruba, l'isiXhosa, le haoussa et l'isiZulu, parlé par des centaines de millions de personnes, ainsi qu'un outil linguistique commercial, VulaVula. Jacaranda Health de Nairobi a créé UlizaLlama pour soutenir la guidance en santé maternelle dans plusieurs langues africaines. Des chercheurs de Sunbird AI en Ouganda ont plaidé pour une approche régionale, construisant une couverture profonde d'un pays à la fois plutôt que de poursuivre une portée globale ici.
La stratégie que ces groupes partagent est révélatrice. Plutôt que de tenter d'outperformer les géants mondiaux, ils privilégient des modèles plus petits, efficaces, ouverts, ajustés pour des langues et des tâches spécifiques, et ils partagent données et benchmarks afin que chaque projet renforce les autres.
Pourquoi c'est si difficile
L'obstacle majeur est les données. La plupart des langues africaines sont ce que les chercheurs appellent « à faible ressource » : il n'y a tout simplement pas assez de texte écrit pour entraîner un modèle de la même manière que les modèles anglais sont entraînés sur une grande partie d'Internet. De nombreuses langues sont principalement orales, leurs empreintes numériques sont minces, leur orthographe n'est pas toujours standardisée.
Cette rareté impose un travail difficile et minutieux : collecte et nettoyage de jeux de données, parfois en enregistrant la parole à partir de zéro, ce qui est lent et coûteux. Elle soulève également des questions éthiques que le domaine prend au sérieux : qui possède les données linguistiques, si les communautés qui les fournissent consentent et sont rémunérées, et comment éviter une nouvelle extraction où les langues africaines sont exploitées pour entraîner des modèles dont ces communautés ne tirent jamais de bénéfice.
Ce qui est en jeu
Le gain n'est pas abstrait. La langue est l'interface à presque tout ce qui est digital, et une IA qui comprend les langues locales peut étendre l'accès de façon spectaculaire. Un agriculteur recevant des conseils agricoles à voix haute dans sa propre langue, une mère recevant des informations de santé qu'elle peut réellement lire, un citoyen accédant aux services gouvernementaux sans maîtriser d'abord l'anglais ou le français, des outils d'appel et d'éducation qui rencontrent les gens où ils se trouvent, ce sont les applications concrètes qui motivent le travail.
Il y a aussi une dimension de souveraineté. Si les systèmes d'IA qui médiatisent de plus en plus l'information, le commerce et les services ne comprennent que quelques langues mondiales, des populations vastes sont poussées à assimiler une langue étrangère juste pour participer, comme les fondateurs de Lelapa l'ont pointé de façon aiguë. Construire une IA locale, c'est en partie s'assurer que les voix africaines soient représentées dans la technologie, pas seulement servies par celle‑ci.
Pourquoi c'est important
Il s'agit du genre de travail qui fait rarement l'objet de levées de fonds médiatiques, mais qui détermine discrètement si l'ère de l'IA inclut la plupart des Africains ou les met à l'écart. C'est peu glamoureux, lourd en données et lent, et il dépend davantage de la collaboration que d'une percée unique. Mais si les langues du continent vont vivre pleinement dans le monde numérique plutôt que de s'y évanouir, les laboratoires qui font ce travail patient et fondamental sont ceux qui posent les bases.